Passende Videos
Einige Videos stehen bewusst auch in anderen Themen-Hubs, wenn die Einordnung dort ebenfalls hilft.
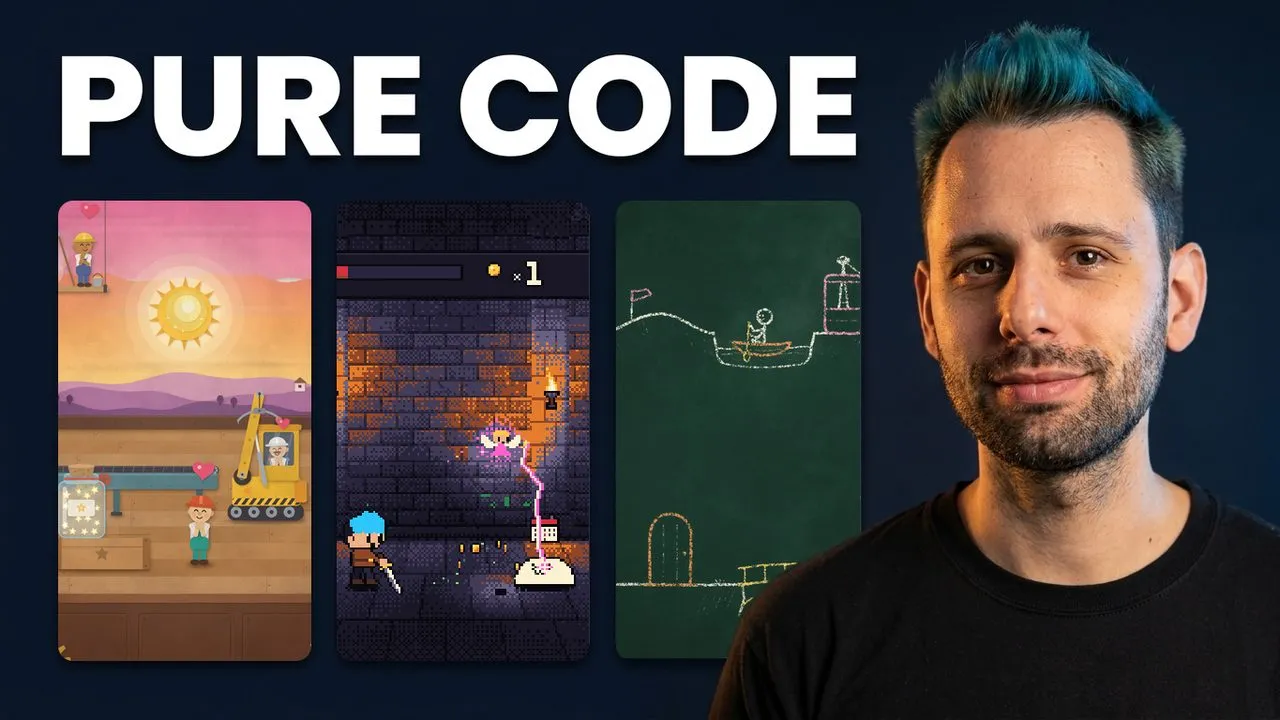
Animationen mit Claude Code: drei Videos aus je einem Prompt
Drei 20-Sekunden-Reels aus je einem Prompt: Papierschnitt, Pixel-Art und ein Kreidetafel-Loop, komplett in Code.
ChatGPT-E-Mails im eigenen Schreibstil getestet
Ein Stil-Briefing für ChatGPT an Kundenmails getestet: erste gegen zweite Version und eine heikle Anfrage nach Gratisarbeit.
Ich habe 6 virale ChatGPT-Foto-Codes getestet. Ohne Slash.
Vorher und nachher zu allen sechs Codes, inklusive der Stellen, an denen ChatGPT ein Tattoo, eine Uhr und ein Hoodie-Logo still verändert hat.
ChatGPT Work vs Codex: Was du wann nutzen solltest
ChatGPT hat inzwischen Chat, Work und Codex. Lukas sortiert ein, wann du schnell fragst, wann du Aufgaben delegierst und wann Codex für Code die klarere Wahl bleibt.
Claude Limits erklärt: 9 Fehler, die Tokens verschwenden
Neun konkrete Stellen, an denen Tokens verschwinden, bevor die eigentliche Arbeit anfängt. Der unspektakulärste Punkt hat bei mir am meisten gebracht.
ChatGPT Images 2 getestet: was wirklich funktioniert
Vier Tests statt Demo-Hype. Bei einem davon hat sich herausgestellt, dass die Websuche nicht das war, wonach sie aussah.
Claude YouTube Audit: wie KI acht Strategieprobleme gefunden hat
Ein Premortem auf echte Kanaldaten. Acht Probleme kamen zurück, und ein paar davon hätte ich lieber nicht gelesen.
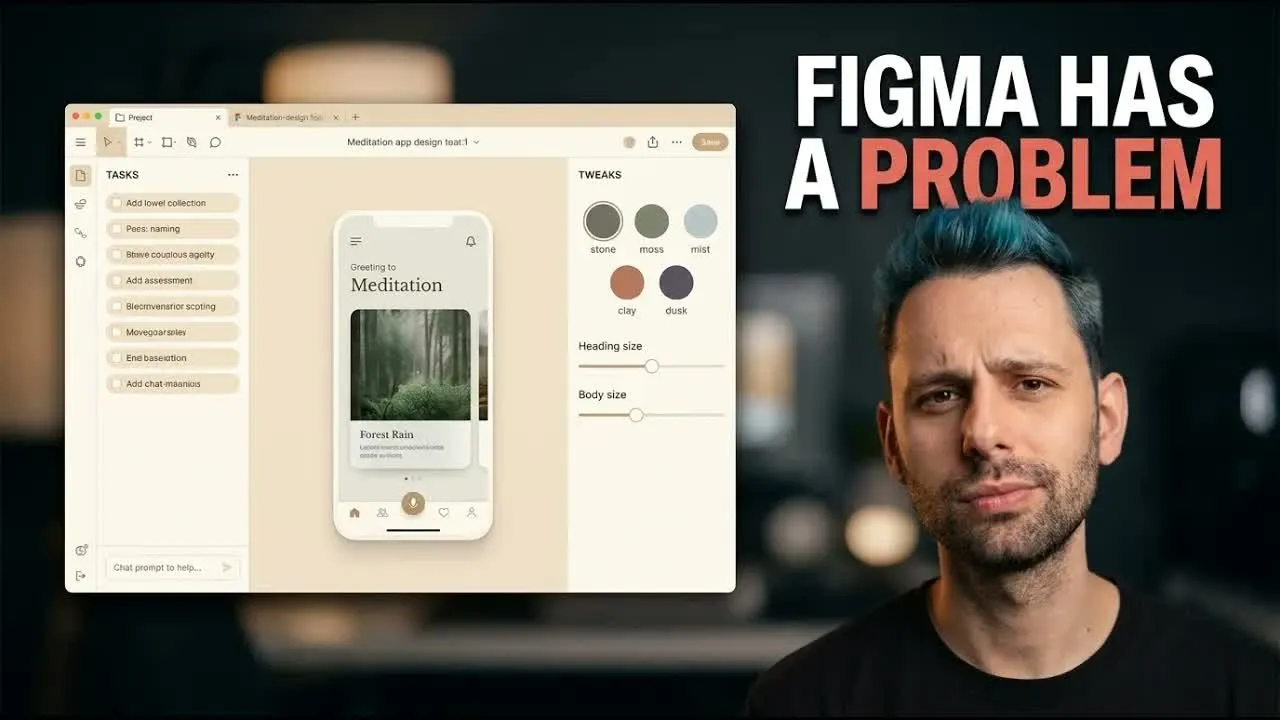
Claude Design erklärt: was Anthropics Design-Tool verändert
Claude Design ist kein normales Modell-Update. Es verschiebt, wo Designarbeit beginnt und wer überhaupt erste visuelle Entwürfe erstellen kann.
Claude Code vs Codex: ein echtes Debugging-Duell
Der vierte Teil der Voicebox-Serie lief nicht nach Plan. Genau deshalb ist er nützlich: Zwei KI-Agenten debuggen ein echtes lokales Setup.
Claude vs Grok: was Emergence World über KI-Agenten zeigt
Fünf virtuelle Städte, unterschiedliche Modelle und eine harte Frage: Verhalten sich KI-Agenten über mehrere Tage stabil, wenn sie Werkzeuge und Regeln bekommen?